


参考资料:https://blog.csdn.net/Geek_of_CSDN/article/details/86527107
今天在复现一份代码的过程中,遇到了一个很神奇的错误——RuntimeError: cuda runtime error (59): device-side assert triggered at …/aten/src/THC/THCCachingHostAllocator.cpp:265,如下图所示。

看到这个错误,第一反应是很懵的,因为从错误提示上看不到任何出错来源。在网上搜到的大部分资料都是建议检查一下label是不是从0开始。由于这份代码读取数据的方式是Pytorch自带的’torchvision.datasets.ImageFolder’和’torch.utils.data.DataLoader’函数,输出的label应该是没问题的,检查之后也是如此(可以使用assert断言进行检查)。继续查找资料,发现有人说可以在代码中加入如下部分进一步定位出错位置:
import os
os.environ['CUDA_LAUNCH_BLOCKING'] = "1"
在尝试过后,发现这个方法很好地解决了这个问题,小编进一步得到了如下的错误提示:
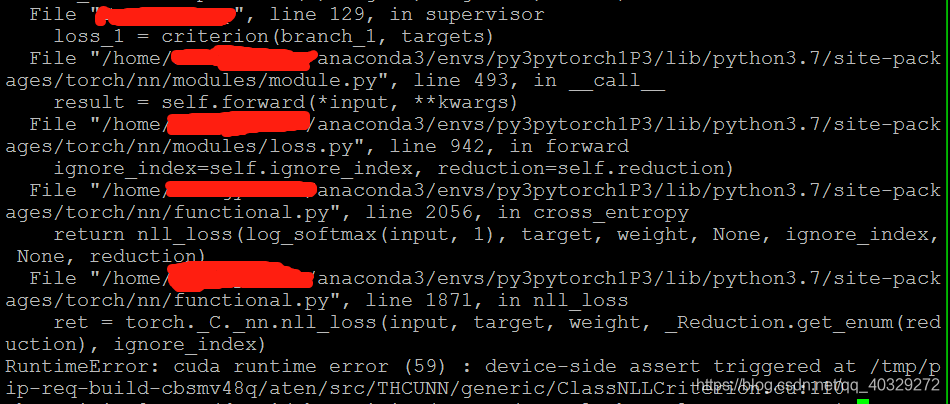
根据这个错误提示,可以看出是loss函数的计算出错了。原因是这部分loss的构建没有使用类别的外部超参,而是使用了内部写死的常数,所以小编在更换数据集的时候只修改了类别的外部超参,没有注意到需要修改这个部分,使得计算loss的两个参数类别数目不一致,导致了程序出错。
总结
可以看出,‘cuda runtime error (59): device-side assert triggered at XXX’ 这个错误的出现大部分是与label有关的,有的是label没有从0开始,有的是label越界。出现这个错误,需要第一时间检查代码中与label有关的部分,实在找不到就尝试加入上述部分代码进一步定位错误。从小编本次查错的经历也可以看出,在写代码的过程中正确使用全局超参是一个好习惯。


